磐石ScienceOne科研智能平台
磐石是什么
磐石(ScienceOne)科学基础大模型由中国科学院自动化研究所发布、中科闻歌产业化,定位为"科学发现的 AI 操作系统"。它以 L1 科学基础大模型为底座,向上构建 L2 学科大模型与 L3 工程技术模型群,目前已跑通 10 个学科、40+ 学科模型,合作方覆盖数学院、高能所、力学所、中科大、上海硅酸盐所、大化所、国家天文台、动物所等科研机构。
用一句话概括磐石对科研团队的价值:把 AI 用到科研全流程,从文献调研到数据分析都能提速——科研老师做判断,它干重活。
平台已有的用户底盘:900+ 所高校、380+ 科研院所、900+ 企业机构入驻,并与清华大学、中国科学技术大学、上海交通大学、浙江大学等十余所高校开展深度共建。
科研全流程八个环节与磐石解法
| 科研环节 | 常见困扰 | 磐石解法与实测效果 |
| 选题探索 | 找研究空白难、方向可行性靠判断、担心重复立项 | 创新评价:跨学科选题发现、项目查重、指标国内外对比与预测;评价周期由数周缩短至 1 小时 |
| 文献调研 | 文献量爆炸、阅读慢、管理混乱 | 文献罗盘:调研由 3–5 天缩短至 20 分钟;精读由 2–5 小时缩短至 30 分钟;4 万字综述由数月缩短至 2.5 小时;公式图表解读准确率由 70% 提升至 90%;文献调研覆盖度提升 59.3% |
| 实验设计 | 参数依赖经验试错,成本高、失败代价大 | 智能体工厂 + 科学实验站:课题组可用自然语言自建实验设计智能体并接入自有工具;材料智能体案例中,设计周期由数月缩短至 30 分钟 |
| 计算仿真 | 一次计算耗时数天至数周,算力紧张,精度与速度难兼顾 | 工具调度台+场基座模型:自主编排 300+ 科学计算工具;力场预测精度最高提升 28.6%,相对传统方法加速 50 倍;力学所高铁流场计算由 5 小时缩短至秒级,误差降低 50% |
| 实验执行 | 重复性差、数据格式不统一、自动化程度低 | 数字细胞大模型+智能体:靶点发现全流程自动化,加速 10 倍以上 |
| 数据分析 | 数据量大、维度高、多模态融合难,代码门槛高 | 波谱场基座模型:谱图到分子结构 top-10 精确匹配率 99.5%,覆盖 IR / Raman / UV / MASS / NMR 全谱系;分子结构预测较当前最优算法平均提升 31%、最高提升 67% |
| 论文写作 | 写作慢、选刊难、语言表达有障碍 | 文献罗盘的写作辅助+创新评价的投稿建议与文稿修订指导,帮助作者在投稿前完善表达、匹配目标期刊 |
| 项目管理与基金申报 | 申报书撰写周期长、多项目并行管理难 | 创新评价:选题查重、研究方向布局差异分析、指标对比;论文潜在错误检出率 80.6%,可在提交前发现大部分规范性与逻辑性问题 |
以上环节共享同一套科学数据与工具底座。数据基座包含论文 1.7 亿篇、专利 1 亿件、基金项目 1800 万项、大科学装置数据 90PB。
三个最有说服力的实际场景
场景一:一篇 4 万字综述,从数月到 2.5 小时
文献调研是科研团队最普遍、也最容易被忽视其耗时的环节。磐石文献罗盘支持文献精读、综述写作与引文回溯,能够生成带证据链的综述初稿,过程可人工干预、可断点续跑。对研究生而言,这直接压缩了从"读不完"到"理不清"之间的时间;对导师而言,文献调研覆盖度提升 59.3% 意味着更少的遗漏与返工。
场景二:跑一次流场仿真,从 5 小时到秒级
计算仿真环节的算力紧张与迭代缓慢,是许多工程类课题组的共同瓶颈。磐石工具调度台可自主规划并调用 300+ 科学计算工具,场基座模型在力场预测上精度最高提升 28.6%、相对传统方法加速 50 倍。中国科学院力学所在高铁流场计算中,将原本约 5 小时的 PDE 求解缩短为秒级响应,误差降低 50%——迭代次数和探索空间都随之放开。
场景三:材料设计,从数月试错到 30 分钟
传统材料研发依赖"炒菜式"试错,一轮实验周期以月计。磐石材料智能体采用层次任务网络规划,实现全自动材料设计。在与上海硅酸盐研究所的合作中,设计周期由数月缩短至 30 分钟,催化活性提升 38%,并已实际发现新材料。同类能力在生命科学方向体现为数字细胞大模型的靶点发现全流程自动化,加速 10 倍以上。
与通用大模型的分界
科研对 AI 的要求与日常办公不同:不需要"说得像专家",而需要"结论站得住"。磐石与通用大模型的差异集中在四点:
| 维度 | 通用大模型 | 磐石 |
| 核心目标 | 像人一样表达与完成任务 | 生成可被科学体系接受的结论 |
| 正确性保障 | 无内生保障,依赖"看起来合理" | 内置验证机制,验证不通过即判失败 |
| 可复现性 | 同一问题多次结果可能不同 | 相同前提下结果稳定一致 |
| 可追溯性 | 推理过程隐含在黑箱中 | 每一步假设、推导与依赖均可拆解 |
磐石的幻觉治理采用双链路:推理侧设置科学逻辑保真度标尺,引用侧绑定证据链,数字幻觉已降至 11%,引用准确率提升 27%。落到一句话上——科学的底线是结论可验证、过程可追溯、错误可修正。
学科对口:哪个方向用哪个模型
磐石的学科模型群按学科对口建设,科研团队可以直接对应到自己的研究方向:
| 研究方向 | 对口学科模型 | 对口能力与案例 |
| 材料科学 | 祝融 | 材料全自动设计;催化活性 +38%、设计效率大幅提升(上海硅酸盐所合作) |
| 生命科学与医药 | 数字细胞大模型 | 靶点发现自动化加速 10 倍以上;蛋白质结构、抗原结合位点预测达领域先进水平 |
| 化学与化工 | — | 谱图到分子结构精确匹配率 99.5%,IR / Raman / NMR 解析;分子结构预测最高提升 67% |
| 物理与力学 | — | 力场预测精度 +28.6%、加速 50 倍;高铁载荷 5 小时缩短至秒级(力学所) |
| 高能物理 | 赛博士 | 北京正负电子对撞机 / 北京谱仪数据分析自动规划,提升模拟与重建效率 |
| 天文 | 金乌 | 恒星耀发预测准确率超 70%;恒星参数反演由周级缩短至分钟级(国家天文台) |
| 环境 | 禹衡 | 环境科学场景模型(低碳、污染监测方向) |
| 空天与遥感 | 临空 | 空天信息场景(对地观测数据处理) |
| 地理 | 坤元 | 地理场景模型 |
| 数学 | 大衍智证 | AI4MATH 方向国际评测领先;已完成 2025 年 Putnam 全部 12 道形式化证明 |
如何开始
磐石支持从零成本验证到整校部署的多级路径,科研团队可以按自己的节奏推进:
| 阶段 | 建议动作 | 涉及角色 |
| 第一步 | 课题组免费试用公开平台,从文献调研环节切入,不改变现有工作流程 | 课题组负责人、研究生 |
| 第二步 | 联合课题或技术共创,用智能体工厂搭建课题组专属智能体 | 课题组、科技处 |
| 第三步 | 课题组或学院订阅,按需选用模块 | 科技处、二级学院 |
| 第四步 | 整校采购或私有化部署,满足数据安全要求 | 信息中心、学校层面 |
磐石邀请注册使用说明
专属用户兑换码为:DH26HYZ1170
用户凭此在注册后的 48 小时内兑换,可获赠 1000 研值积分
具体咨询:刘老师 15699825125
登录及兑换码使用指引:
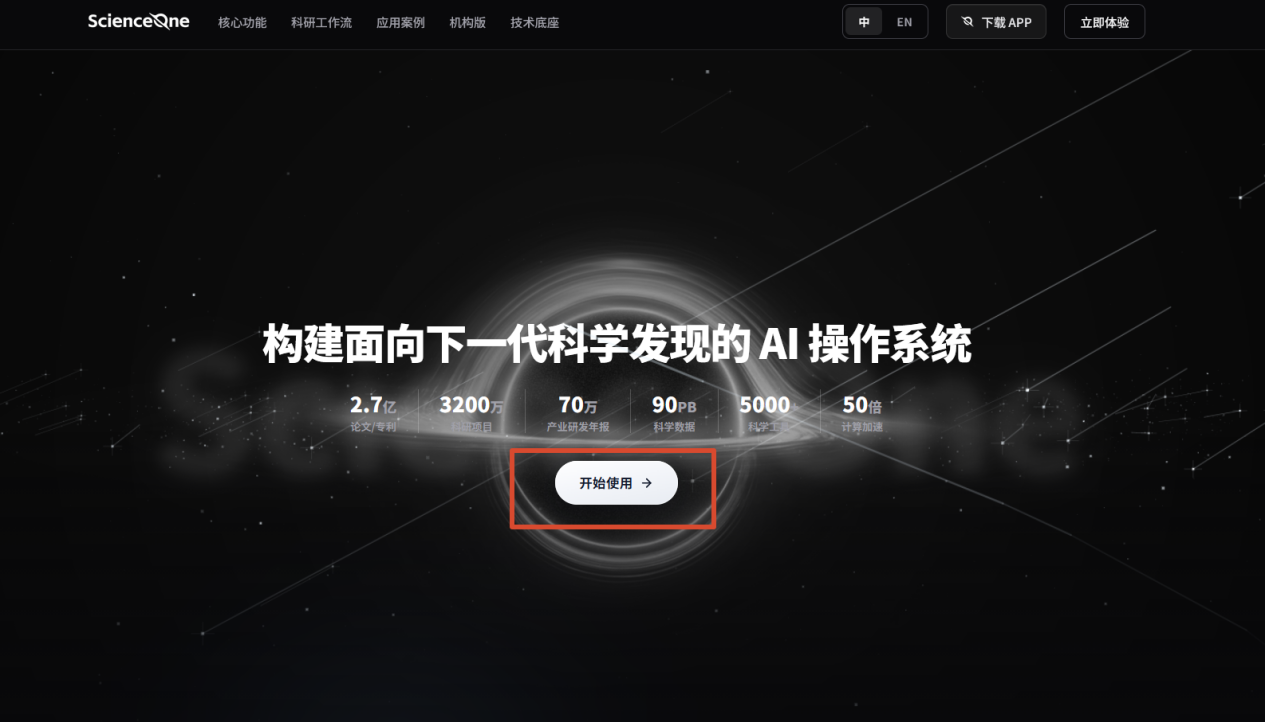
1、登录注册:复制网址 https://www.scienceone.ai 至浏览器,使用手机号验证登录即自动注册成功
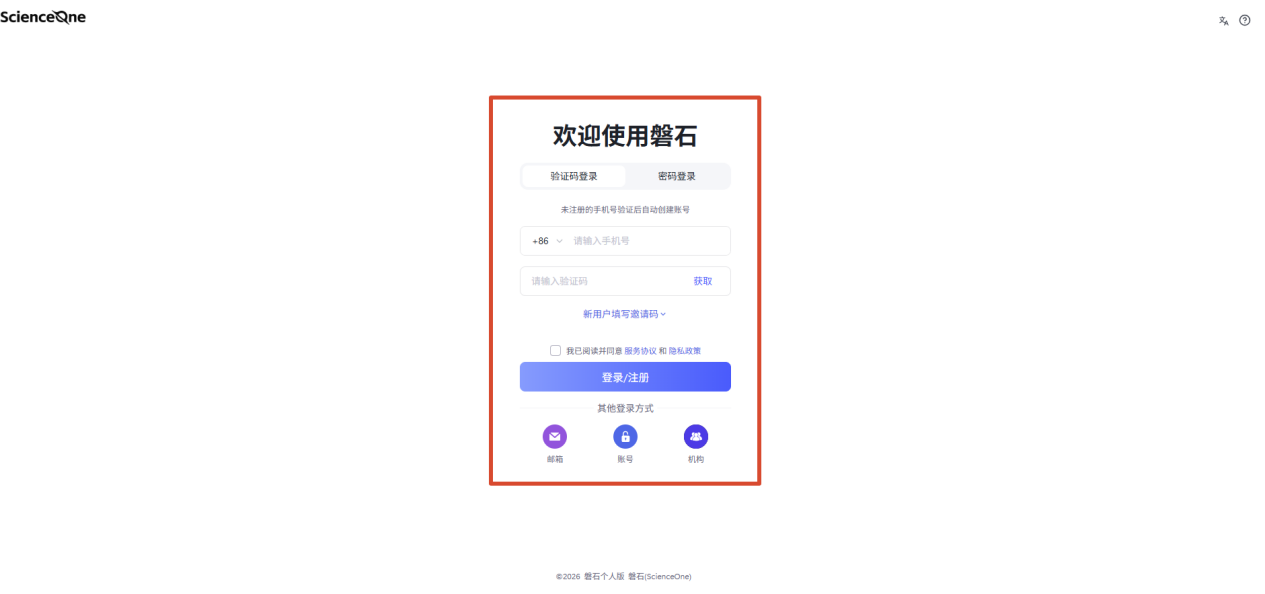
登录后界面如下:
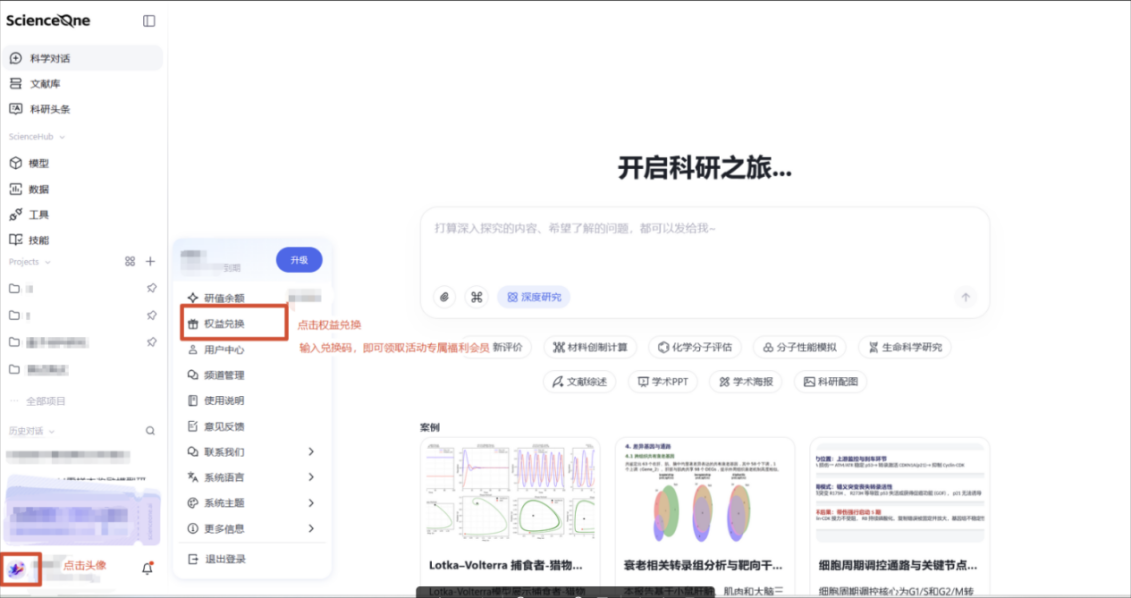
3、登录后点击头像,点击权益兑换,输入专属兑换码DH26HYZ1170,即可获得活动专属福利会员。
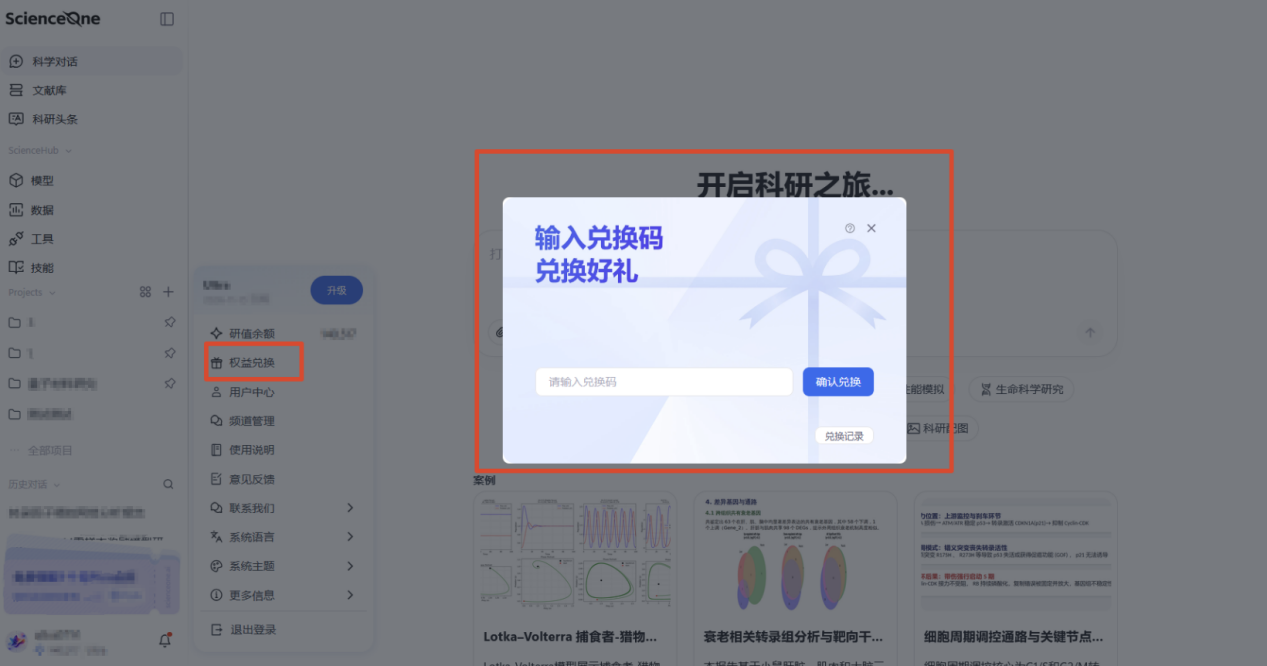
如图,在对应弹窗输入专属兑换码,即可兑换会员。
官网入口为:
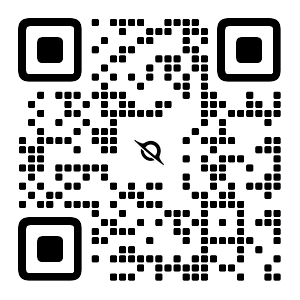
https://www.scienceone.ai
官网二维码,可直接使用下方图片:
建议演示环境:
请使用 Microsoft Edge(最新版) 或 Google Chrome(最新版) 进行演示,
我们对这两款主流浏览器做了深度适配,能最大程度避免兼容性问题,保证界面和交互响应顺畅。
同时,演示期间,请暂时关闭您用于访问境外网络的 VPN/代理工具(即“梯子”),可确保页面加载、数据交互及实时反馈达到最优速度。